XLSTAT による傾向スコアマッチング:観察研究で比較する2群の背景をそろえよう
- 傾向スコアマッチングとは?
- なぜ「そのまま比較」してはいけないのか:交絡変数の問題
- 傾向スコアとマッチングの仕組み
- 傾向スコアマッチングを実行するためのデータセット
- XLSTAT で傾向スコアマッチングを実行する手順
- 傾向スコアマッチングの結果の解釈
- マッチング後のデータの活用
- まとめ
- 参考文献
- XLSTAT の無料トライアル
傾向スコアマッチングとは?
傾向スコアマッチング(Propensity Score Matching)とは、観察研究において「処置を受けた群」と「受けなかった群」の背景要因をそろえ、2群を公平に比較できるようにするための手法です。例えば「新しい治療薬を投与された患者と、投与されなかった患者の予後を比べたい」、「研修プログラムに参加した人と参加しなかった人の、その後の成果を比べたい」といった場面で用いられます。
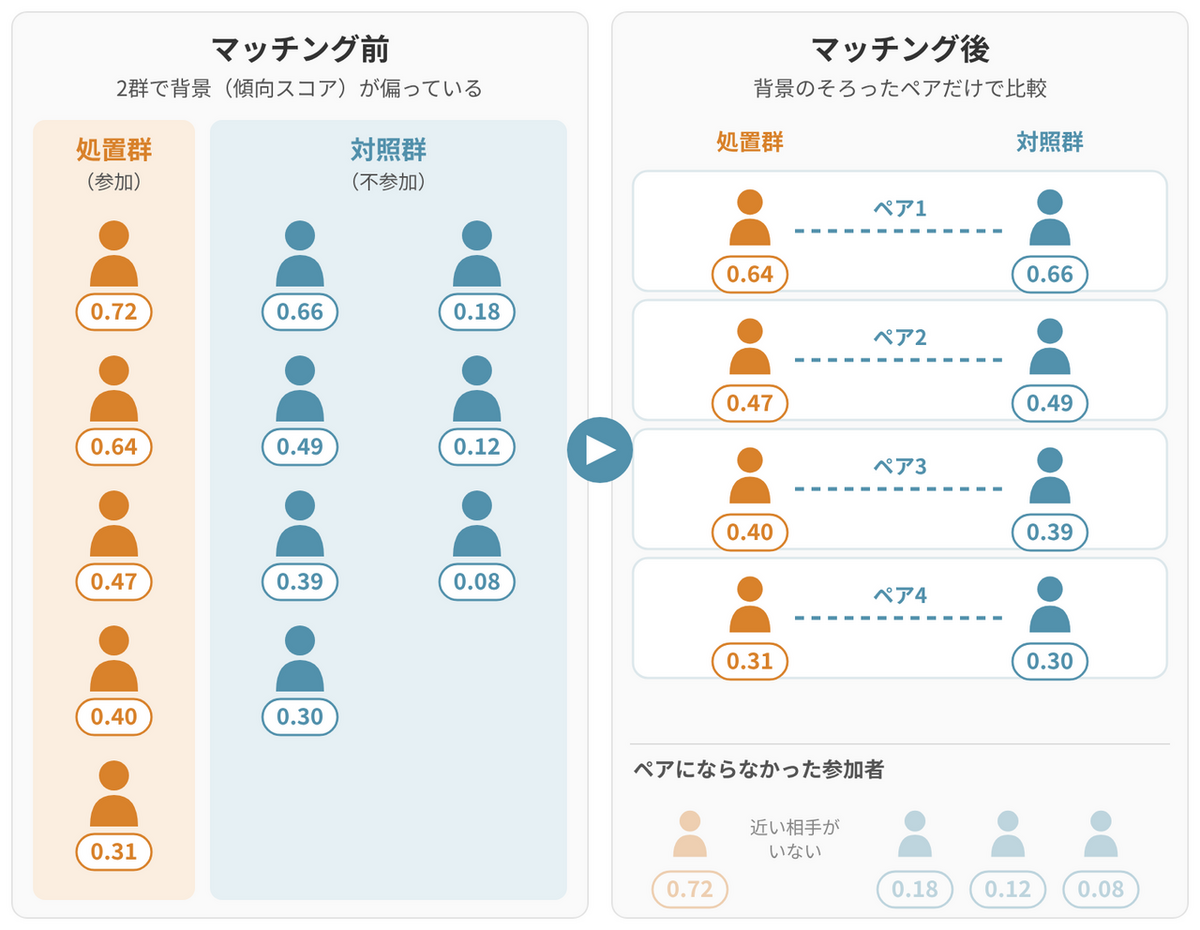
ランダム化比較試験であれば、参加者は無作為に群に割り付けられるため、2群の背景は平均的にそろいます。しかし、倫理的・法的・経済的な理由や、単に実施上の事情から無作為な割り付けができない研究も少なくありません。このように無作為な割り付けを行わない観察研究では、群によって参加者の特徴が偏ったままになりやすく、傾向スコアマッチングはその偏りを小さくするための代表的な手法の一つです。
このページでは、傾向スコアマッチングの考え方と、XLSTAT での実行手順、結果の読み方をご紹介します。
なぜ「そのまま比較」してはいけないのか:交絡変数の問題
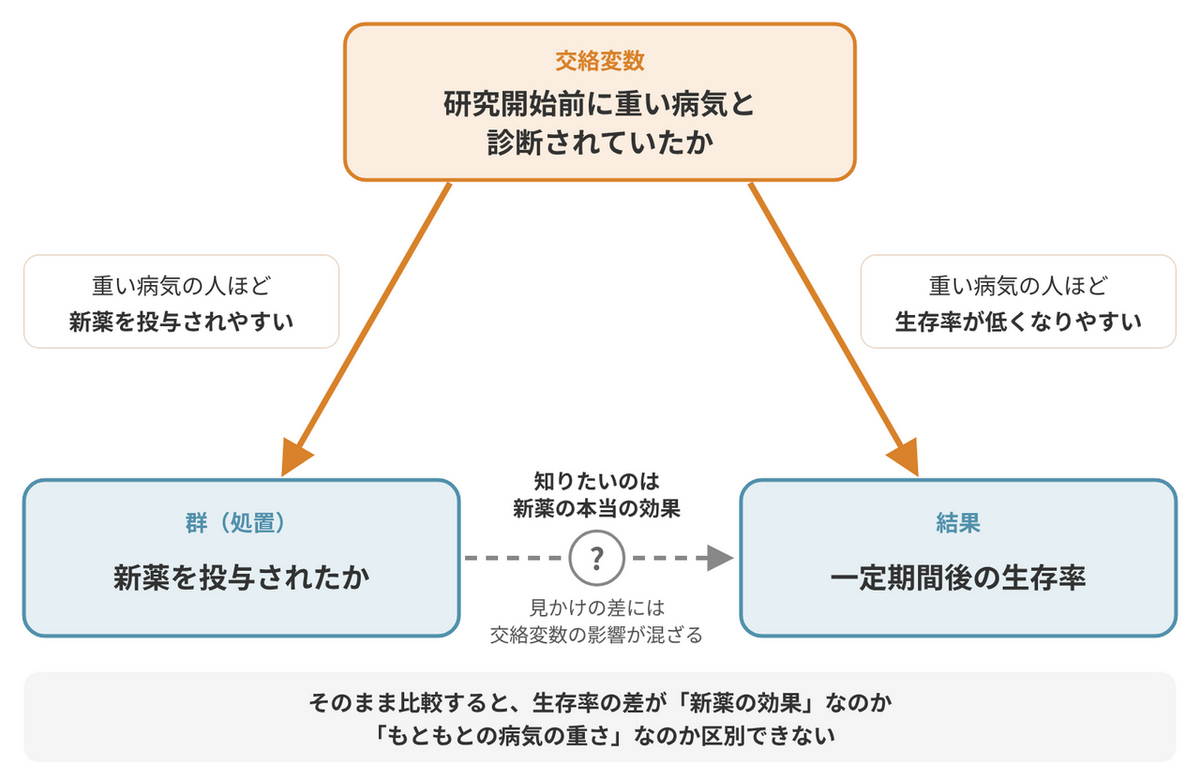
ある病気に対する新薬の効果を調べる研究を例に考えてみましょう。新薬を投与された群(処置群)と投与されなかった群(対照群)について、一定期間後の生存率を比べたところ、処置群の生存率のほうが低かったとします。この結果だけを見ると「新薬には効果がない」、さらには「新薬は健康に悪影響を及ぼす」と結論づけたくなるかもしれません。
ところが実際には、同じ病気の患者でも、 新薬はもともと重症の人に多く投与されており、対照群は比較的軽症の人が中心だったとしたらどうでしょうか。処置群の生存率が低いのは新薬のせいではなく、もともとの重症度の違いによる可能性があります。
この例の「治療開始前の重症度」のように、どちらの群に属するかに影響し、同時に結果にも影響しうる変数を交絡変数(交絡因子)と呼びます。交絡変数の影響を取り除かないまま2群を比較すると、結果に深刻な偏り(バイアス)が生じます。傾向スコアマッチングは、この交絡変数の影響をできるだけ小さくするために用いられます。
傾向スコアとマッチングの仕組み
傾向スコアとは
傾向スコアとは、交絡変数の値が与えられたときに、ある参加者が処置群に属する確率のことです。Rosenbaum と Rubin(1983)によって提唱された考え方で、複数の交絡変数の情報を「処置群に入りやすさ」という1つの数値にまとめたものと言えます。
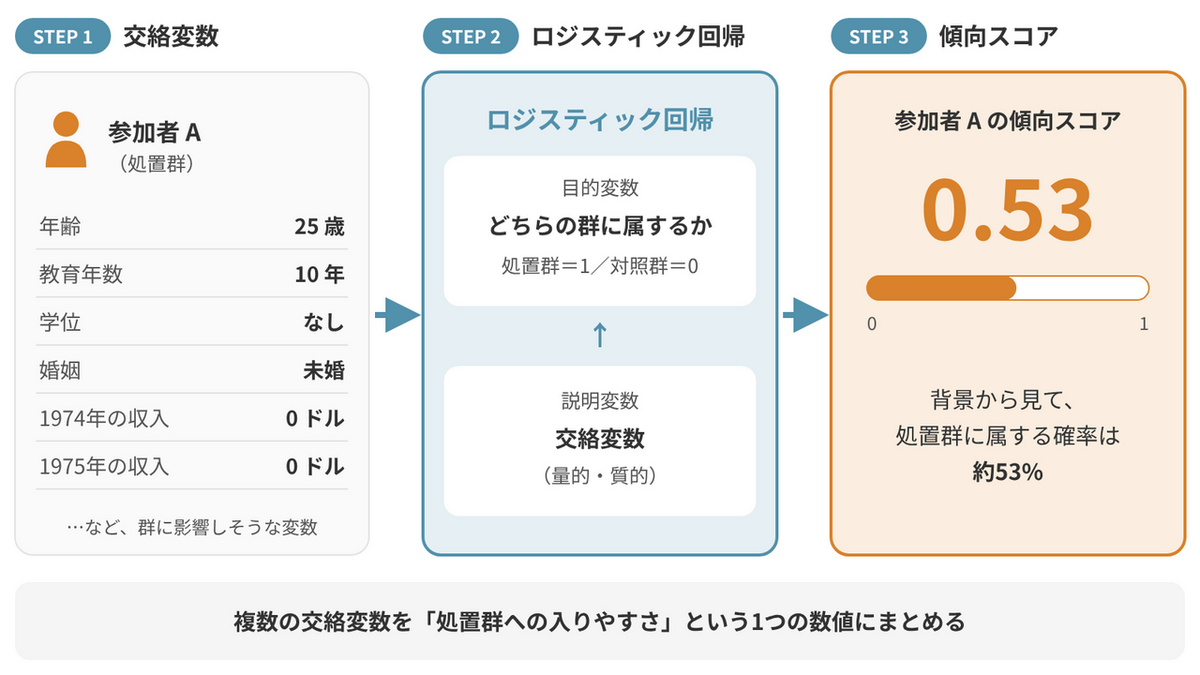
XLSTAT では、傾向スコアをロジスティック回帰(ロジット・モデル)で推定します。群を表す2値の変数(処置群/対照群)を目的変数に、交絡変数と考えられる変数を説明変数にしてモデルを当てはめ、各参加者の「処置群に属する確率」を計算します。説明変数には量的変数と質的変数のどちらも使用でき、変数間の交互作用を含めることもできます。
参考:XLSTAT によるロジスティック回帰:利用状況から契約の更新有無を予測しよう
マッチングの考え方
傾向スコアを推定したら、処置群と対照群から、スコアが近い参加者同士を組み合わせます。こうして2群を作り直すことで、群全体として、モデルに含めた背景要因の分布が近づくことが期待できます。ただし、実際に背景がそろったかどうかは、マッチング後に各変数を確認する必要があります。
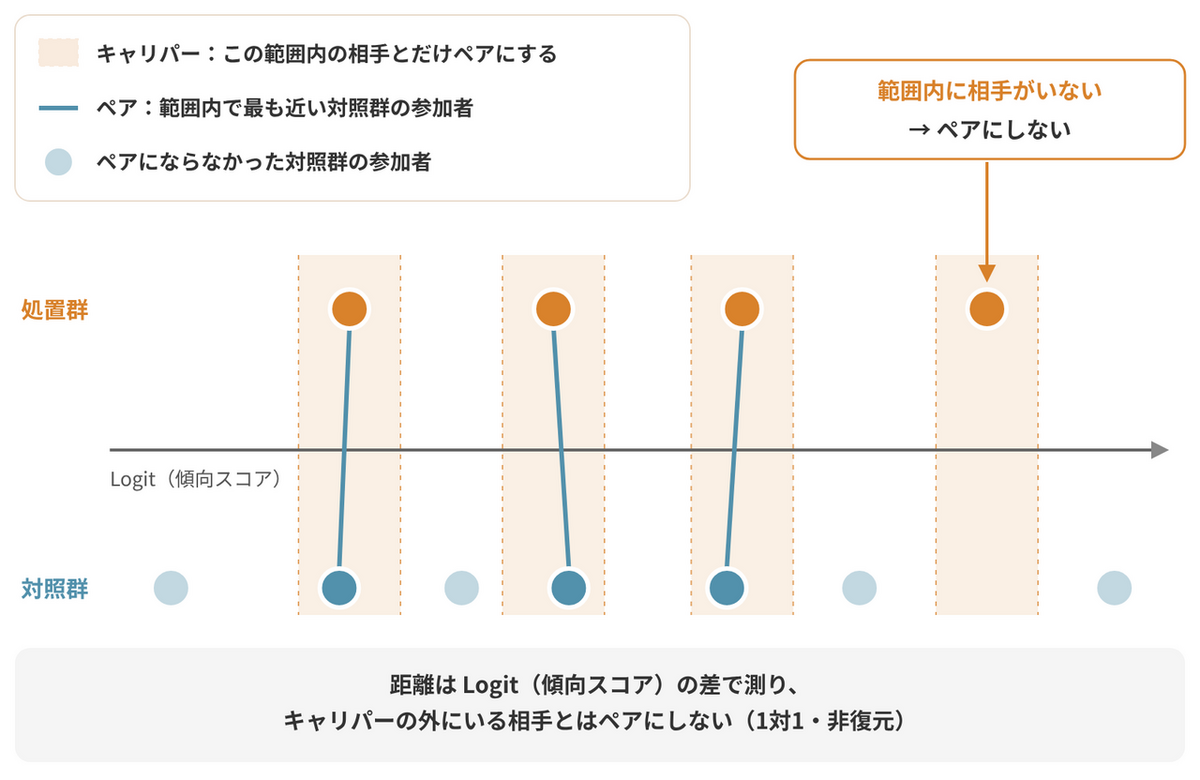
XLSTAT では、参加者同士の近さを傾向スコアそのものではなく、傾向スコアのロジット(対数オッズ)の差で評価します。距離の計算方法には ユークリッド距離と マハラノビス距離の2種類が用意されています。
キャリパー:離れすぎた相手とはペアにしない
傾向スコアが「最も近い」相手であっても、実際には大きく離れていることがあります。そのような相手と無理にペアを作ると、背景の違いが残り、比較結果に偏りが生じるおそれがあります。 そこで、「この距離を超える相手とはペアにしない」という上限を設けることができます。この上限をキャリパーと呼びます。
XLSTAT では、キャリパーを「処置群と対照群それぞれのロジット傾向スコアのばらつき(σ)に係数を掛けた値」として設定します。係数の値について文献上の強い合意はありませんが、0.1、0.2、0.25 がよく用いられます。XLSTAT ではこれらに加えて 0.5、1 も選択でき、任意の値を指定することも可能です。
2つのマッチング・アルゴリズム
XLSTAT では、ペアを決める方法として「欲張りアルゴリズム」と「最適アルゴリズム」の2つのアルゴリズムが用意されています。いずれも、一度ペアになった対照群の参加者は、ほかの参加者のペアには使われません(非復元抽出)。
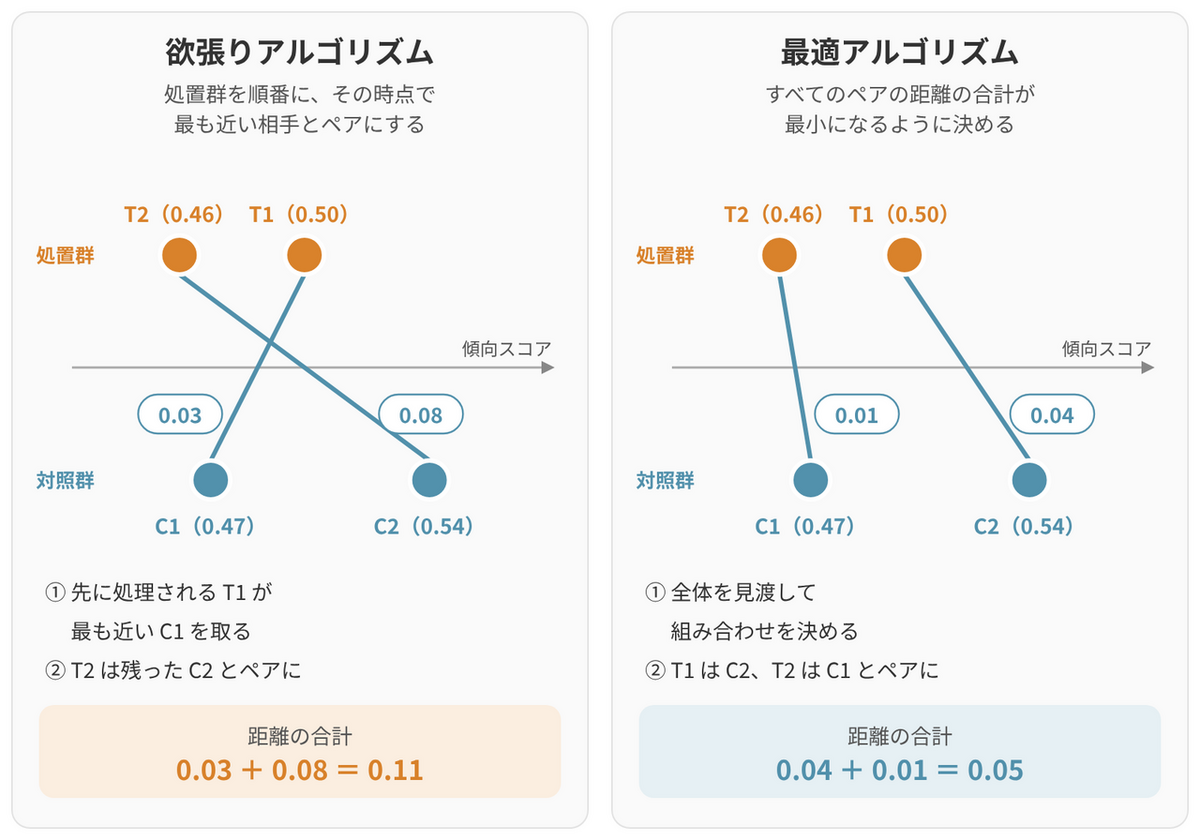
| 欲張りアルゴリズム | 最適アルゴリズム | |
| ペアの決め方 | 処置群の参加者を順番に、その時点で最も近い対照群の参加者とペアにしていく | すべてのペアの距離の合計が最小になるように、全体を一度に最適化する(最小費用流) |
| 処置群の並び順の影響 | 受ける(先に処理された参加者が近い相手を先に取るため) | 受けない |
| 並び順への対策 | [行をシャッフル] オプションで処理順を無作為にできる | 不要 |
| 追加機能 | - | [群をバランスさせる] で、質的変数のカテゴリの割合を処置群と対照群でそろえられる |
どちらのアルゴリズムでも、処置群の1人に対して対照群の1人をペアにする「1対1」、指定した人数をペアにする「1対多」、対照群の全員をいずれかの処置群の参加者に割り当てる「1対全」を選択できます。
傾向スコアマッチングを実行するためのデータセット
事例:職業訓練プログラムへの参加と交絡変数
今回は、LaLonde(1986)が公表し、Dehejia と Wahba(1999)で再分析されたデータから無作為に抽出した200名分のデータを使用します。もともとは、ある職業訓練プログラムへの参加が1978年の収入に与える効果を調べた研究のデータです。
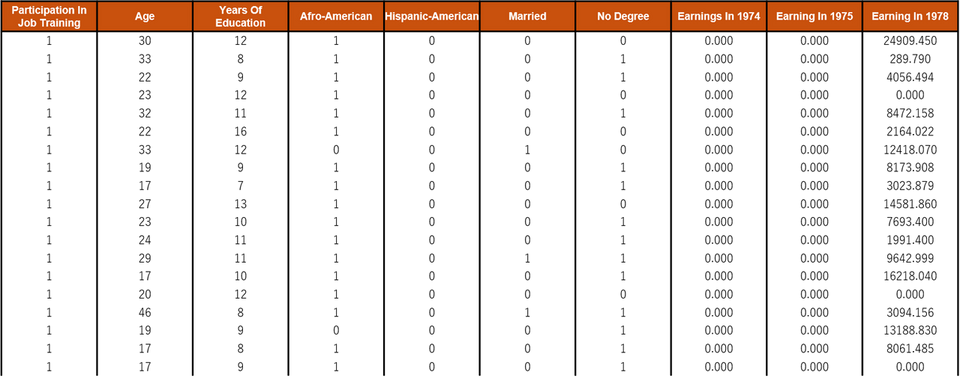
プログラム参加者の1978年の収入が非参加者より高かったとしても、その差には、年齢や教育年数など、もともとの背景の違いが影響している可能性があります。そこで、傾向スコアマッチングを使って背景の偏りを小さくし、比較用のデータを作成します。
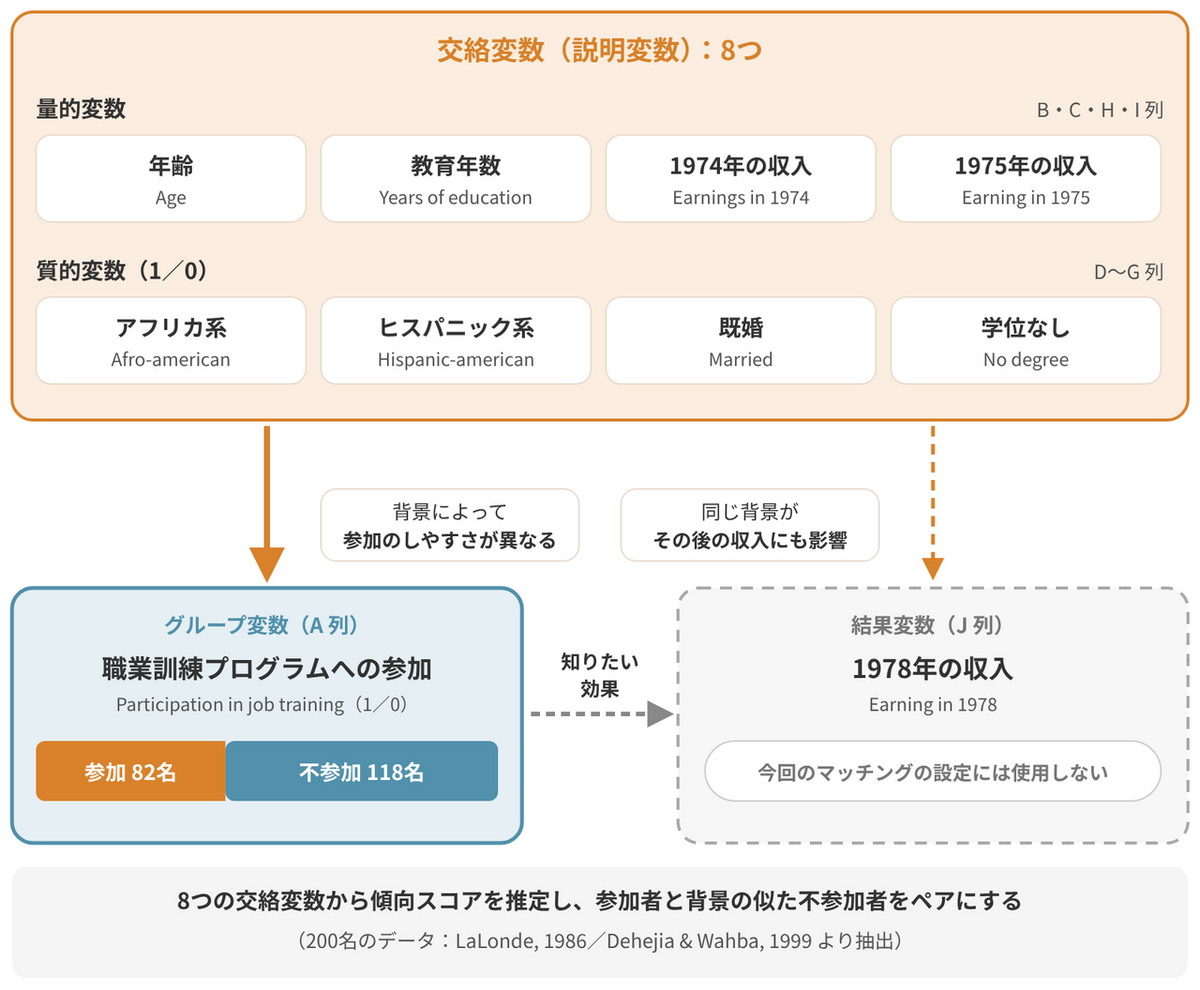
200名のうち、プログラムに参加したのは82名、参加しなかったのは118名です。
グループ変数:
- Participation in job training:職業訓練プログラムに参加したかどうか(1 = 参加, 0 = 不参加)
交絡変数(説明変数)として、以下の8つの変数を使用します。
量的変数:
- Age:年齢(歳)
- Years of education:教育年数
- Earnings in 1974:1974年の収入(1978年ドル換算)
- Earning in 1975:1975年の収入(1978年ドル換算)
質的変数:
- Afro-american:アフリカ系アメリカ人であれば1、そうでなければ0
- Hispanic-american:ヒスパニック系アメリカ人であれば1、そうでなければ0
- Married:既婚であれば1、そうでなければ0
- No degree:学位を持っていなければ1、持っていれば0
なお、J 列の Earning in 1978(1978年の収入)は元の研究で効果を測りたかった変数(結果変数)ですが、今回のマッチングの設定には使用しません。
サンプルデータのダウンロードはこちらから
dataset-for-propensity-score-matching.xlsmXLSTAT で傾向スコアマッチングを実行する手順
-
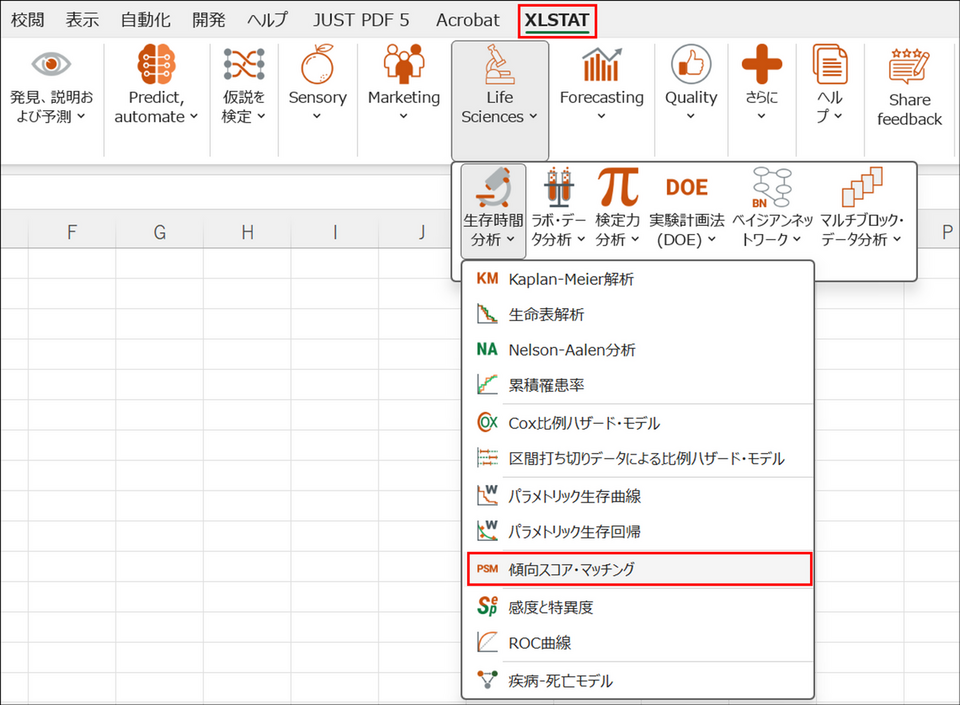
XLSTAT を起動し、[Life Sciences] > [生存時間分析] > [傾向スコア・マッチング] を選択します。
-
[傾向スコア・マッチング] のダイアログボックスが表示されたら、[一般] タブで以下の設定をします。
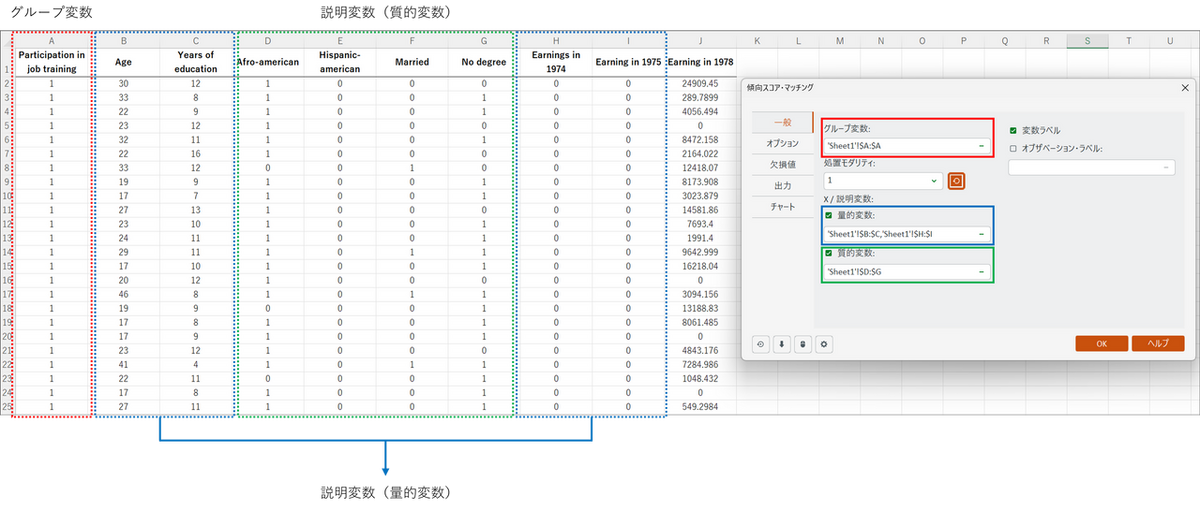
- グループ変数:
A 列の「Participation in job training」を選択します。 - 処置モダリティ:
処置群を表すカテゴリとして [1] を選択します。グループ変数を選択すると、カテゴリが自動で検出されドロップダウンに表示されます。表示されない場合や、選択を変更したのに表示が更新されない場合は、右側の更新ボタンをクリックしてください。 - X / 説明変数:
[量的変数] にチェックを入れ、B 列・C 列・H 列・I 列(Age、Years of education、Earnings in 1974、Earning in 1975)を選択します。離れた列は Ctrl キーを押しながら選択できます。 [質的変数] にチェックを入れ、D 列〜G 列(Afro-american、Hispanic-american、Married、No degree)を選択します。 - 変数ラベル:
見出しの行も選択しているため、チェックを入れます。
- グループ変数:
-
[オプション] タブに切り替え、以下を設定します。
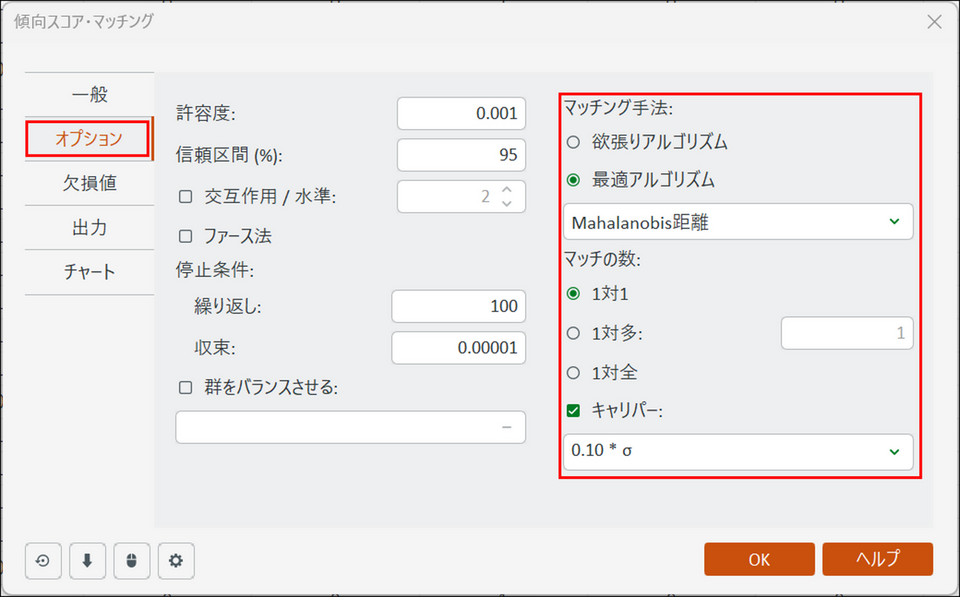
- マッチング手法:
[最適アルゴリズム] を選択し、その下のドロップダウンで [Mahalanobis距離] を選択します。 - マッチの数:
[1対1] を選択します。 - キャリパー:
チェックを入れ、ドロップダウンで [0.10 * σ] を選択します。
許容度、信頼区間 (%)、停止条件(繰り返し・収束)は初期値のままで構いません。
【補足】欲張りアルゴリズムを使う場合
[マッチング手法] で [欲張りアルゴリズム] を選択すると、[行をシャッフル] オプションが利用できるようになります。欲張りアルゴリズムは処置群の並び順によって結果が変わるため、このオプションで処理の順番を無作為にすることができます。また、[群をバランスさせる] は最適アルゴリズムでのみ利用できるオプションで、指定した質的変数のカテゴリの割合が、処置群とマッチング後の対照群で同じになるようにペアを作ります。
- マッチング手法:
-
[出力] タブで、下記画面のように設定します。
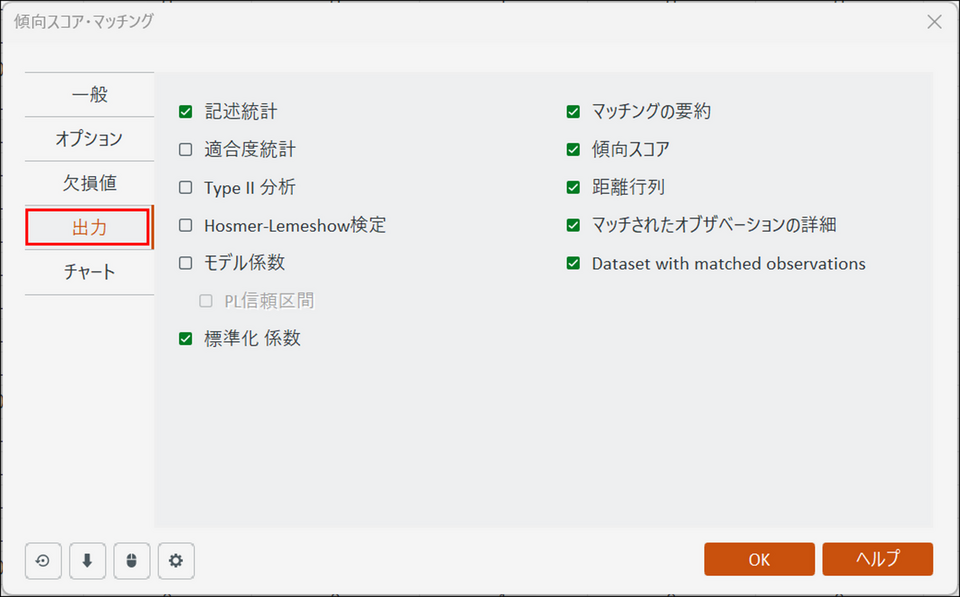
今回は [記述統計]、[標準化 係数]、[マッチングの要約]、[傾向スコア]、[距離行列]、[マッチされたオブザベーションの詳細]、[Dataset with matched observations] にチェックを入れます。
-
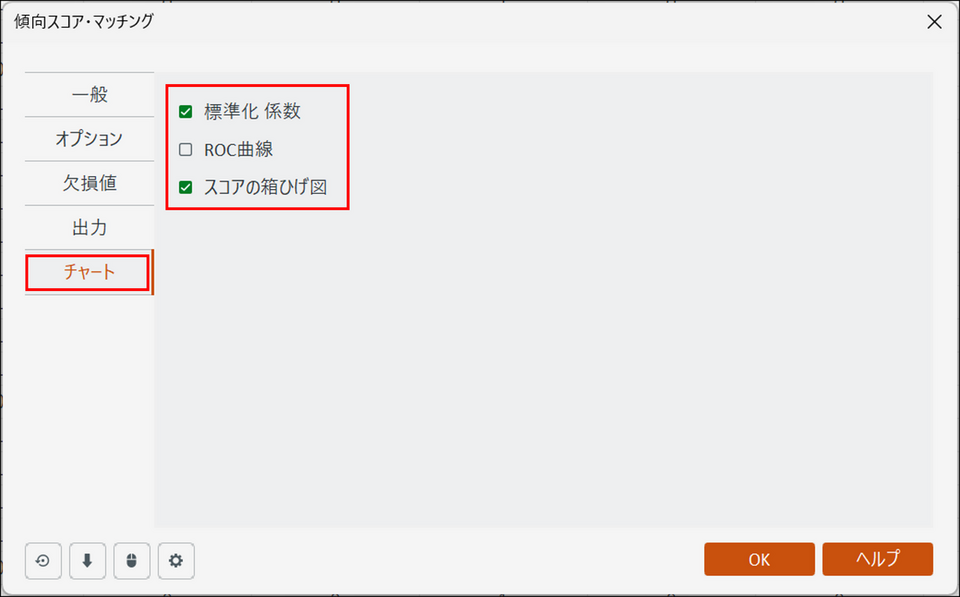
[チャート] タブで、[標準化 係数] と [スコアの箱ひげ図] にチェックを入れます。
-
[OK] ボタンをクリックすると計算が始まり、結果が別シート(PSM)に出力されます。
傾向スコアマッチングの結果の解釈
記述統計
結果の最初には「記述統計」の表が出力されます。マッチングの前に、分析対象のデータに間違いがないか、どのような特徴があるかを確認するために使います。
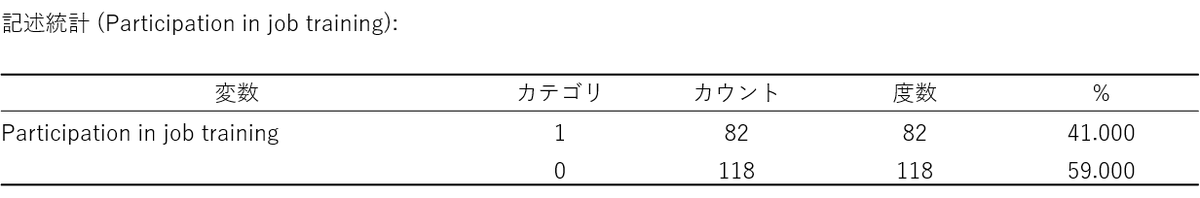
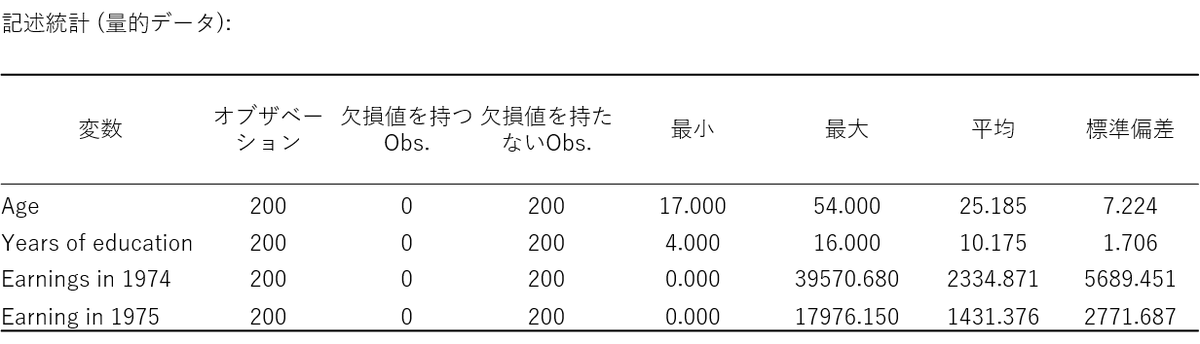
今回は200名すべてについて欠損値がなく、年齢は17〜54歳(平均25.2歳)、教育年数は4〜16年(平均10.2年)となっています。グループ変数の内訳は、参加(1)が82名(41%)、不参加(0)が118名(59%)です。
標準化係数
「標準化 係数」の表とグラフは、傾向スコアを計算するために当てはめたロジスティック回帰モデルの係数を、変数の単位に左右されない形で示したものです。係数の絶対値が大きいほど、その変数がプログラムへの参加しやすさに強く関係していることを意味します。
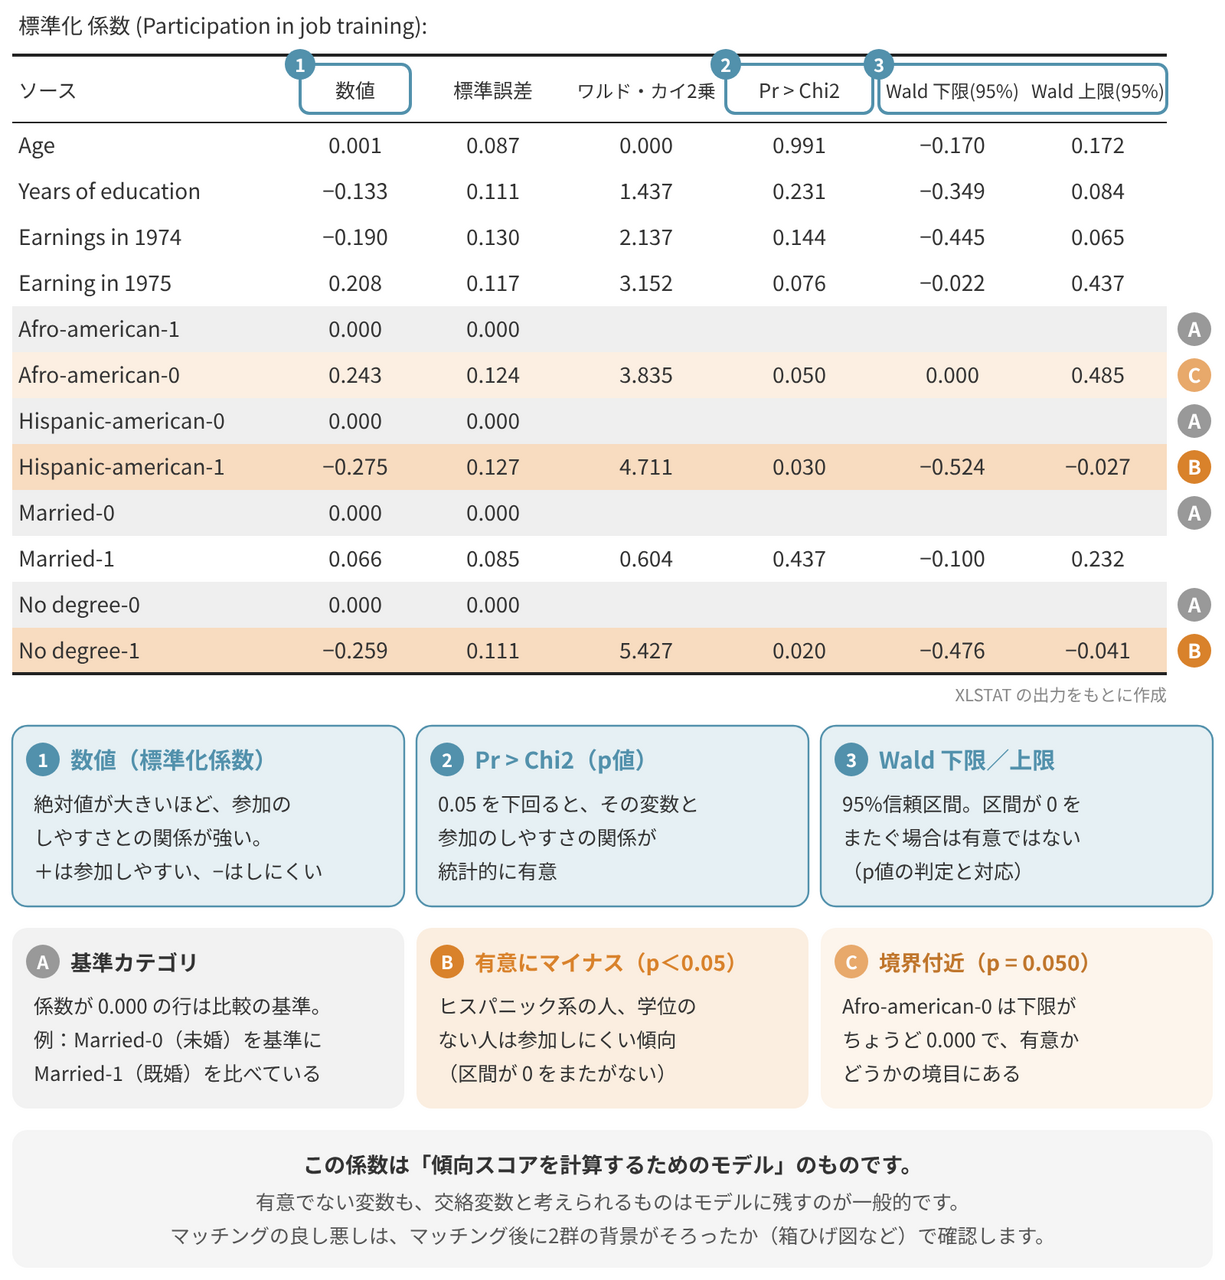
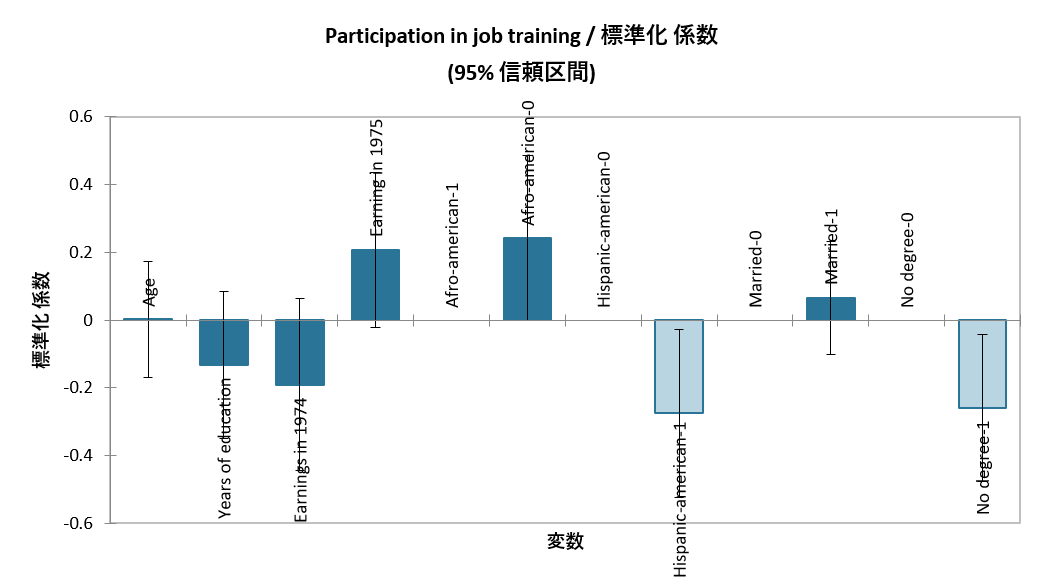
今回の結果では、Hispanic-american-1(−0.275、p = 0.030)、No degree-1(−0.259、p = 0.020)の係数がマイナスで、p値が0.05を下回っています。これは、今回のデータでは、ほかの説明変数の条件が同じ場合、「ヒスパニック系アメリカ人である人」はそうでない人に比べて、「学位を持っていない人」は持っている人に比べて、プログラムに参加しにくい傾向があったことを示しています。また、Afro-american-0(0.243、p = 0.050)も、境界付近ではあるものの参加のしやすさに関係していることがうかがえます。このように、プログラムへの参加には背景要因が関係しており、参加者と非参加者をそのまま比較すると、背景の違いによって結果に偏りが生じるおそれがあります。なお、各質的変数のうち係数が0 になっているカテゴリ(Afro-american-1、Hispanic-american-0、Married-0、No degree-0)は、比較の基準となるカテゴリです。
【補足】この表で係数の有意性を重視しすぎない
傾向スコアマッチングにおけるロジスティック回帰は、ある変数が参加に影響しているかどうかを検証するためではなく、一人ひとりの傾向スコアを計算するために使われています。そのため、p値が0.05 を上回った変数であっても、交絡変数として考えられるものはモデルに含めておくのが一般的です。マッチングがうまくいったかどうかは、後述する箱ひげ図などで2群の背景がそろったかどうかで確認します。
マッチされたオブザベーションの要約
「マッチされたオブザベーションの要約」の表は、マッチングによって何名がペアになったかをまとめたものです。
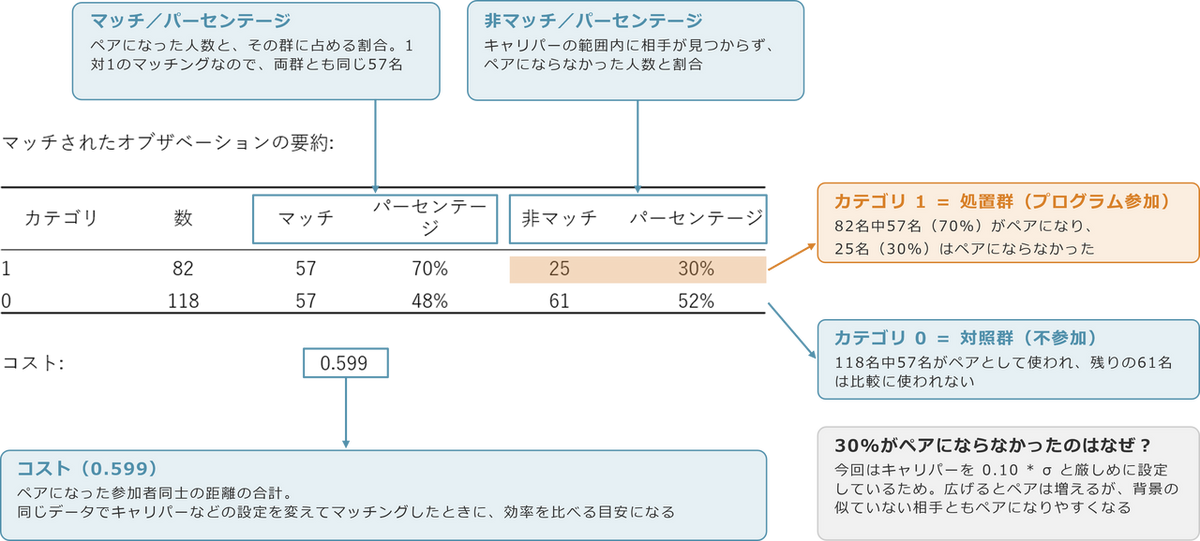
処置群(カテゴリ1)は82名中57名(70%)がペアになり、25名(30%)はペアになりませんでした。対照群(カテゴリ0)は118名中57名(48%)がペアになっています。1対1のマッチングなので、ペアになった人数は両群とも同じ57名です。
処置群の25名がペアにならなかったのは、キャリパー(0.10 * σ)の範囲内に、ペアにできる対照群の参加者が見つからなかったためです。キャリパーを狭く設定するほど、背景の似たペアだけが残る一方で、ペアにならない参加者が増えます。キャリパーを広げればペアの数は増えますが、似ていない相手ともペアになりやすくなります。
表の下に表示される「コスト」(今回は0.599)は、ペアになった参加者同士の距離の合計です。同じデータで設定を変えてマッチングを行う場合に、マッチングの効率を比較する目安として使えます。
傾向スコア
「傾向スコア」の表には、200名全員について計算された傾向スコアと、その95% 信頼区間の下限・上限が表示されます。
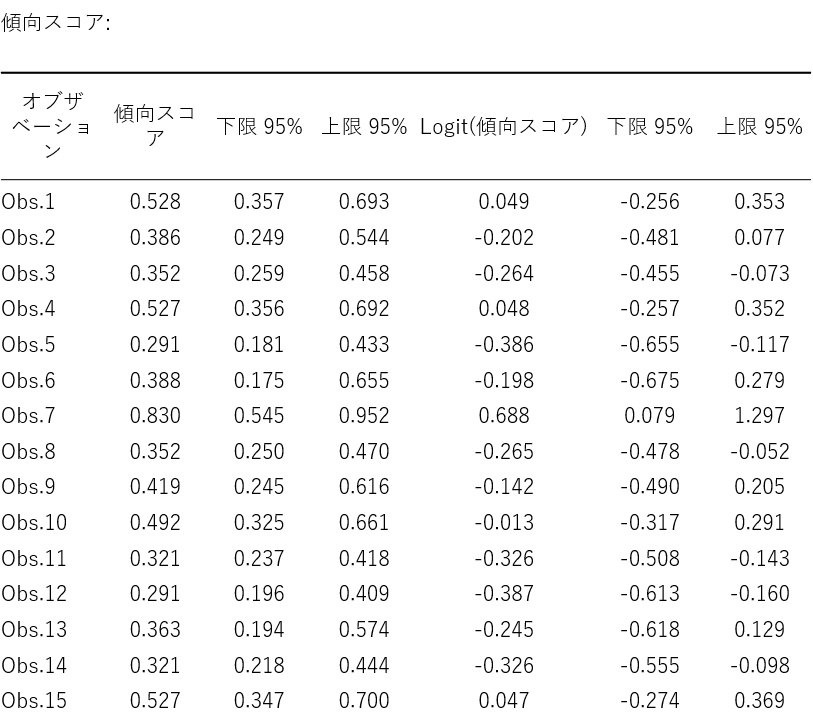
例えば Obs.1 の傾向スコアは0.528 で、背景要因から見て「プログラムに参加する確率は約53%」と推定されたことを意味します。表の右側にある Logit(傾向スコア)は傾向スコアをロジット(対数オッズ)に変換した値で、参加者同士の距離の計算には、こちらの値が使われます。
【補足】Logit(傾向スコア)の計算方法
Logit(傾向スコア)は、次の2つのステップで計算されています。Obs.1(傾向スコア0.528)を例に見てみましょう。
ステップ1:オッズを求める
まず、「参加する確率」を「参加しない確率」で割ります。この値をオッズと呼び、「参加する可能性が、参加しない可能性の何倍か」を表します。
Obs.1 の場合、参加する確率は0.528、参加しない確率は 1 − 0.528 = 0.472 なので、オッズは 0.528 ÷ 0.472 ≒ 1.12 です。参加する可能性が、参加しない可能性の約1.12倍ということになります。
ステップ2:常用対数をとる
次に、このオッズが「10の何乗か」を求めます。この操作を常用対数(log10)をとると言います。例えば、100は10の2乗なので常用対数は2、10は10の1乗なので1、1は10の0乗なので0です。
Obs.1 のオッズ1.12は、10の0.049乗にあたります。したがって、Logit(傾向スコア)は0.049 となります。
Excel で同じ計算をする場合は、傾向スコアがB2 セルに入っているとして、=LOG10(B2/(1-B2)) と入力します。
|
オブザベーション |
傾向スコア |
ステップ1:オッズ | ステップ2:Logit(傾向スコア) |
| Obs.1 | 0.528 | 0.528 ÷ 0.472 ≒ 1.12 | 0.049 |
| Obs.7 | 0.830 | 0.830 ÷ 0.170 ≒ 4.88 | 0.688 |
| Obs.5 | 0.291 | 0.291 ÷ 0.709 ≒ 0.41 | −0.386 |
Logit(傾向スコア)は、次のように読み取ることができます。
- 0:参加する・しないが五分五分(傾向スコア0.5)
- プラス:参加しやすい背景を持っている
- マイナス:参加しにくい背景を持っている
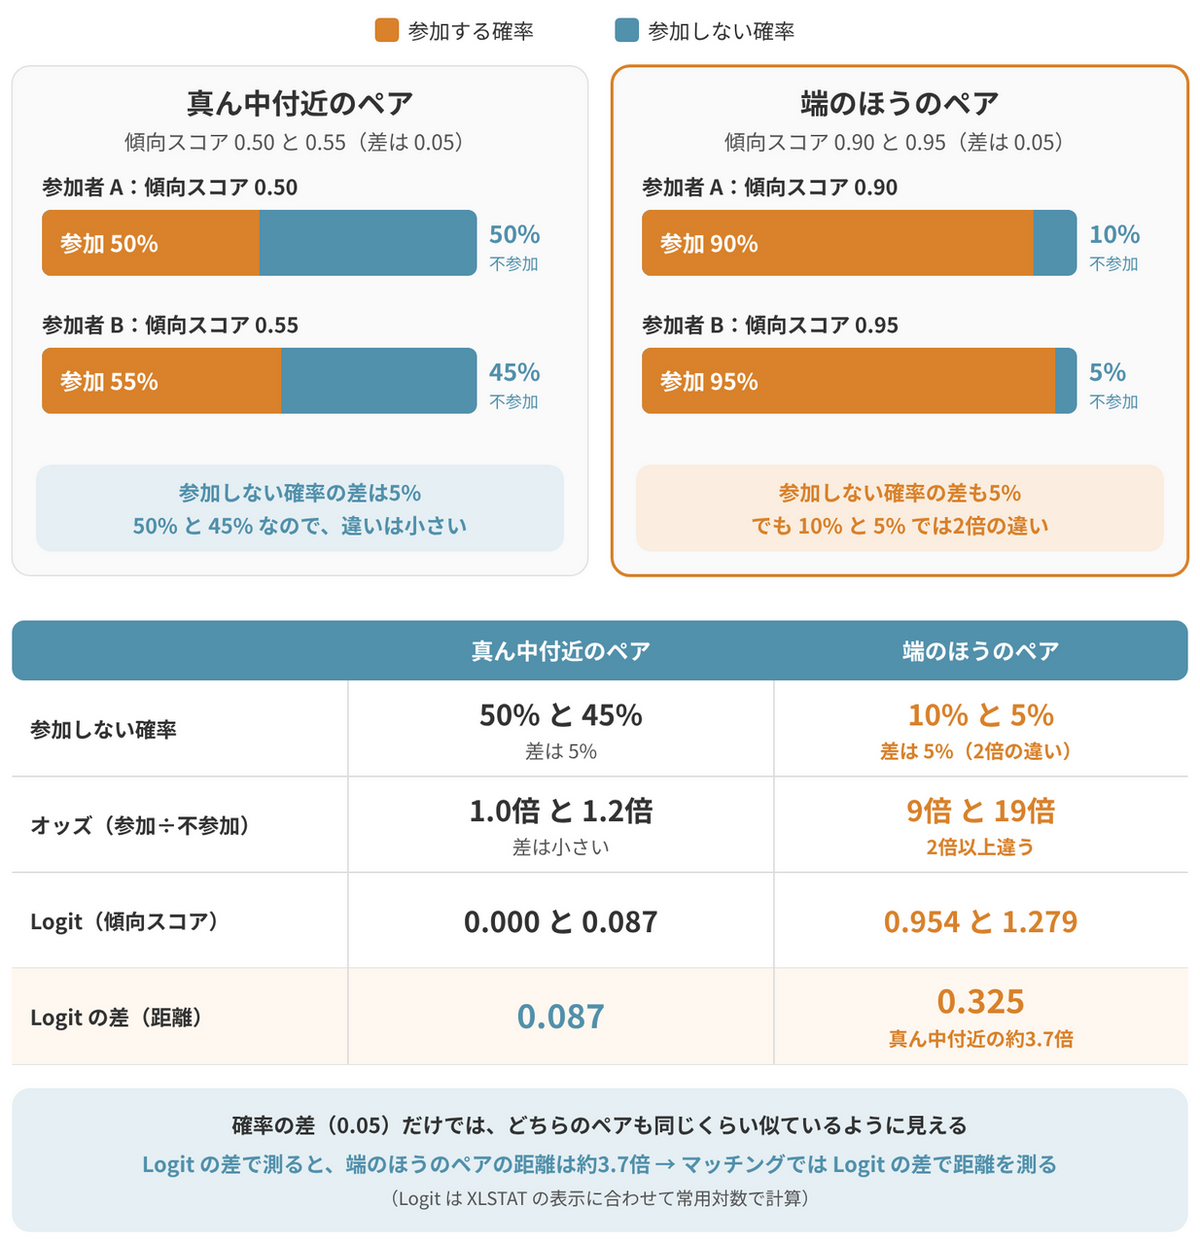
なぜわざわざ変換するのかというと、確率のままでは0や1に近い部分の違いが小さく見えてしまうためです。例えば、0.50と0.55の差も、0.90と0.95の差も、確率で見れば同じ0.05です。しかしオッズで見ると、前者は1.0倍から1.2倍への変化であるのに対し、後者は9倍から19倍へと大きく変わっています。ロジットに変換することで、こうした背景の違いの大きさを距離に正しく反映できるようになります。
距離行列
「距離行列」は、処置群の参加者(行)と対照群の参加者(列)のすべての組み合わせについて、Logit(傾向スコア)にもとづく距離を示したものです。
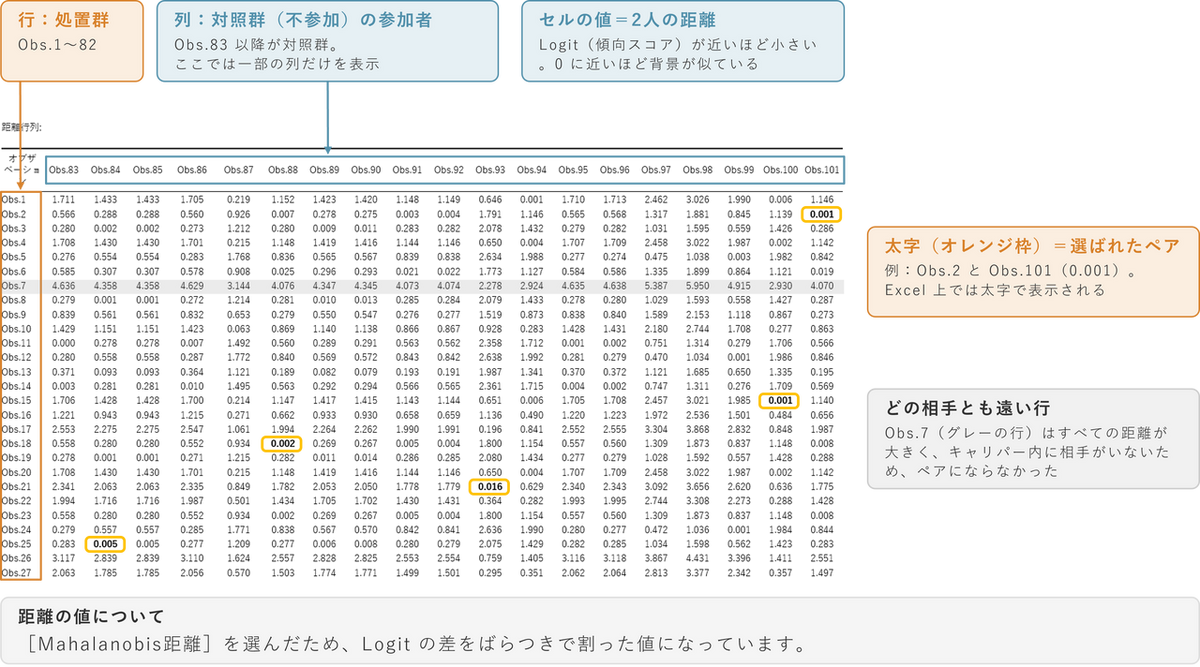
値が小さいほど、2名の傾向スコアが近い(背景が似ている)ことを意味します。実際のExcel シートでは、ペアとして選ばれた組み合わせの距離が太字で表示されます。
スコアの箱ひげ図
「箱ひげ図」は、Logit(傾向スコア)の分布を、以下の4つのグループについて並べて表示したものです。
- Participation in job training | 1(合計):処置群全体
- Participation in job training | 1(マッチ):処置群のうちペアになった参加者
- Participation in job training | 0(マッチ):対照群のうちペアになった参加者
- Participation in job training | 0(合計):対照群全体
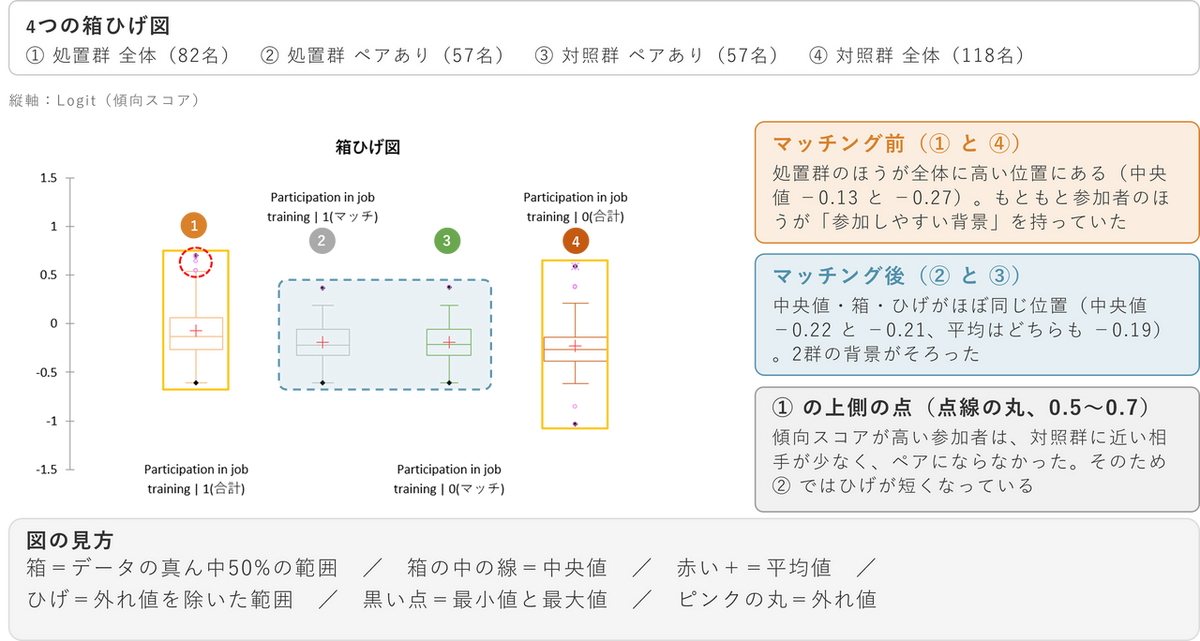
マッチング前の処置群全体(左端)と対照群全体(右端)を比べると、処置群のほうが全体的に高い位置にあり、分布の形も異なっています。これは、もともと参加者のほうが「参加しやすい背景」を持っていたことを示しています。
一方、マッチング後の処置群(左から2番目)と対照群(左から3番目)の箱ひげ図は、中央値・箱の範囲・ひげの範囲がほぼ同じ位置にそろっています。マッチングによって、2群の傾向スコアの分布、つまり背景要因が比較可能な状態に近づいたことが視覚的に確認できます。
また、処置群全体では上側に伸びていたひげが、マッチング後には短くなっています。傾向スコアが高い参加者に対しては、対照群に同程度のスコアを持つ相手が少なく、その多くがペアにならなかったためです。
マッチされたオブザベーションの詳細
「マッチされたオブザベーションの詳細」の表には、ペアになった処置群と対照群の参加者の組み合わせと、それぞれの Logit(傾向スコア)、ペア間の距離が一覧で表示されます。
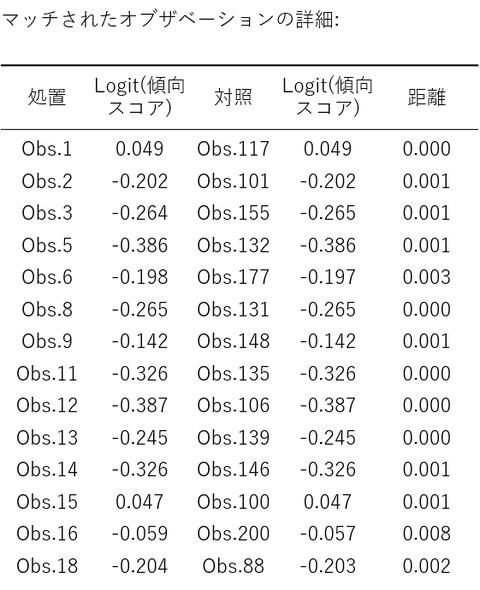
例えば1行目は、処置群の Obs.1 と対照群の Obs.117 がペアになり、両者の Logit(傾向スコア)がいずれも0.049 で、距離が0.000 であることを示しています。今回の57組のペアでは、最も離れたペアでも距離は0.053 にとどまっています。
マッチング後のデータの活用
[出力] タブで [Dataset with matched observations] にチェックを入れていた場合、結果シートの最後に、ペアになった114名(57組)だけを抜き出したデータセットが出力されます。グループ変数と、マッチングに使用したすべての説明変数が含まれています。
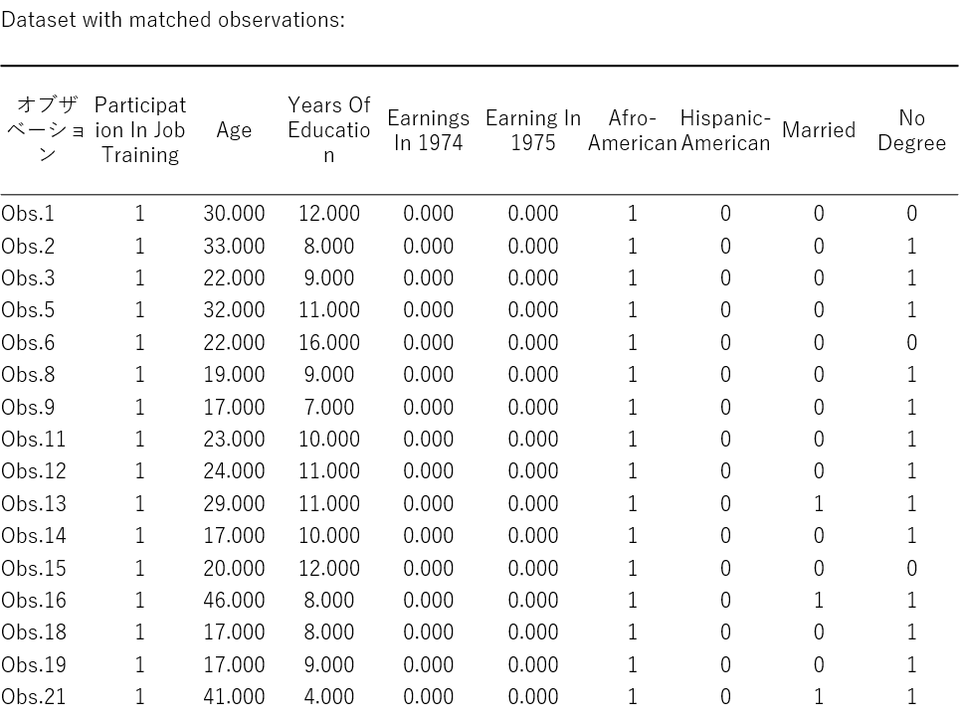
このデータセットを使って群ごとの平均や割合を算出すると、マッチングの前後で2群の背景がどのように変わったかを確認できます。今回の例では、次のようになりました。
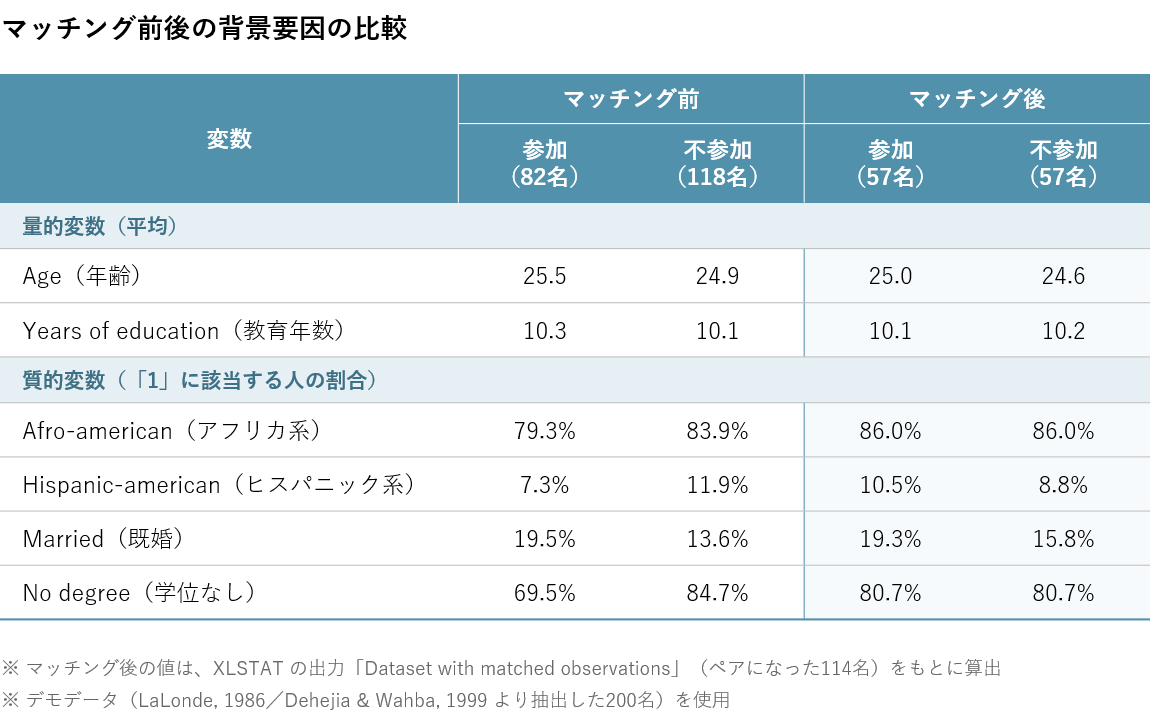
例えば「学位を持っていない人(No degree = 1)」の割合は、マッチング前は参加者69.5%、不参加者84.7%と15ポイント以上の差がありましたが、マッチング後はどちらも80.7%にそろっています。このように背景をそろえたデータを用いて、元の研究で知りたかった結果(今回の例では1978年の収入)を2群で比較することで、交絡変数による偏りを抑えた比較が可能になります。
【補足】【補足】マッチングで調整できるのは「測定された」変数だけ
傾向スコアマッチングでそろえられるのは、モデルに含めた変数だけです。データに含まれていない要因(例えば本人の意欲など)による偏りは取り除くことができません。どの変数を交絡変数としてモデルに含めるかは、研究の分野における知見にもとづいて検討する必要があります。
まとめ
傾向スコアマッチングは、無作為な割り付けができない観察研究において、処置群と対照群の背景要因をそろえ、交絡変数による偏りを小さくするための手法です。複数の交絡変数をロジスティック回帰で「処置群に入りやすさ(傾向スコア)」という1つの数値にまとめ、その値が近い参加者同士をペアにすることで、比較可能な2群を作り直します。
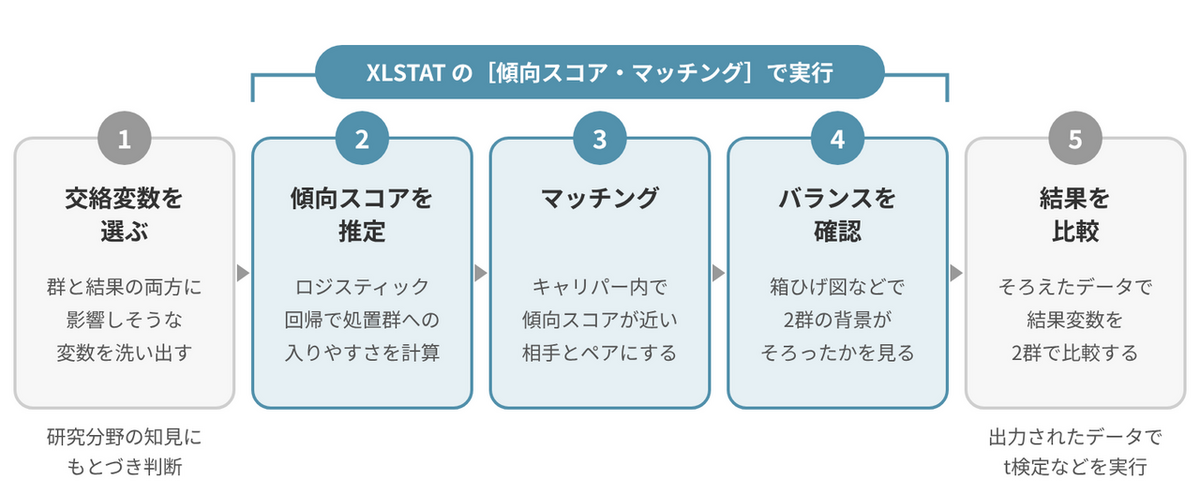
今回の例では、最適アルゴリズム・Mahalanobis距離・1対1・キャリパー0.10 * σ の設定で、処置群82名のうち57名と対照群57名がペアになりました。箱ひげ図からは、マッチング前に偏っていた傾向スコアの分布が、マッチング後にはほぼそろったことが確認できました。
XLSTAT を使えば、使い慣れたExcel 上で傾向スコアの推定からマッチング、ペアの一覧や箱ひげ図による確認、マッチング後のデータセットの出力までを一度に行うことができます。観察データを用いた群間比較の前処理として、ぜひご活用ください。
参考文献
- XLSTAT: Propensity score matching in Excel
https://community.lumivero.com/s/article/6587-propensity-score-matching-excel?language=en_US
XLSTAT の無料トライアル
トライアルでは、最上位パッケージ XLSTAT Advanced に加え、3D Plot と LatentClass のオプションもご利用いただけます。本記事で紹介した傾向スコアマッチングは XLSTAT Advanced でご利用いただけます。
無料トライアルを申し込む*トライアルは登録完了日に開始され、有効期間は14日間です。トライアルを更新または延長することはできません。